Estás usando mal la IA: el chat del navegador se queda corto
Por qué el chat del navegador limita tu IA y cómo trabajar con carpetas, memoria y archivos con Claude, Codex, Gemini y Antigravity. Con fuentes.
Sabino Figueroa
Lead Solutions Architect en DWC
Abres una pestaña, escribes una pregunta, copias la respuesta y cierras. Mañana repites: vuelves a explicar quién eres, qué haces y cómo quieres que te hable. Si trabajas así, estás usando una herramienta enorme como si fuera un buscador.
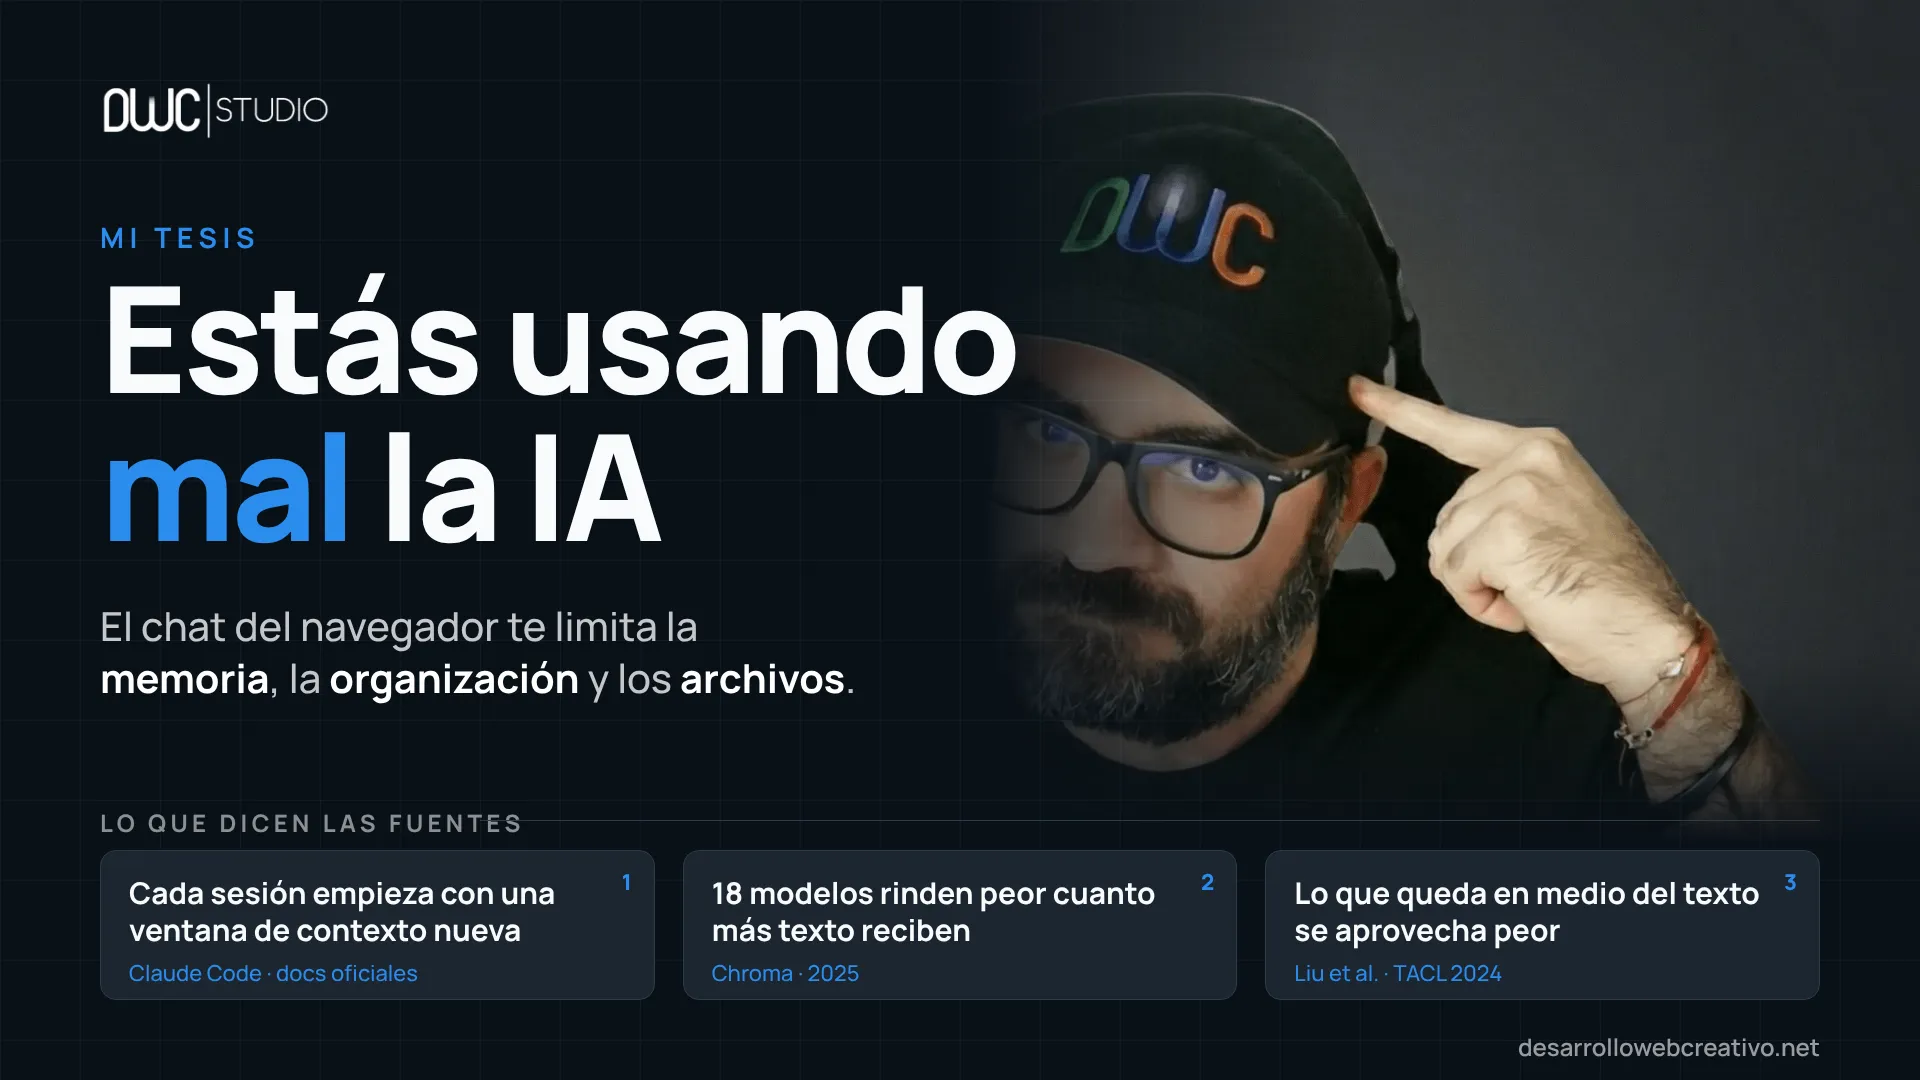
Mi tesis es sencilla: el problema casi nunca es la IA, es dónde y cómo la usas. El chat del navegador es la puerta de entrada y está bien para empezar. Pero cuando la IA pasa a ser parte de tu trabajo diario, ese formato te limita en tres cosas: lo que recuerda de lo que hacéis, cómo se organiza lo que te entrega y cuánto trabajo puedes dejar archivado para retomarlo mañana.
Hay otra forma de trabajar, la que usan los desarrolladores con herramientas como Claude Code, Codex, Gemini CLI o Antigravity. En este artículo te explico qué cambia, qué dicen las fuentes oficiales y, algo que casi nadie cuenta, dónde está el límite de esa "memoria". Spoiler: la IA no recuerda más por arte de magia. Recuerda porque tú le dejas notas bien escritas.
En 30 segundos
- Cada conversación de IA empieza con una "mesa de trabajo" vacía. Lo que no está en esa mesa, la IA no lo sabe.
- En el chat del navegador, esa mesa la llenas tú a mano cada vez. Con Proyectos y memoria mejora, pero tus archivos siguen viviendo dentro de la herramienta.
- Las herramientas por carpeta (Claude Code, Codex, Gemini CLI, Antigravity) leen archivos de tu ordenador al empezar. Esos archivos son la memoria: texto normal que tú controlas [1][5][6].
- Más memoria no es mejor memoria. Los estudios muestran que los modelos rinden peor cuando les metes demasiado texto [8][9].
- Lo que funciona: una carpeta por proyecto, un archivo corto de reglas, datos confirmados guardados aparte y un resumen al cerrar cada sesión.
¿Qué te limita cuando usas la IA solo en el chat del navegador?
Para entenderlo, imagina que la IA es un colaborador brillante que llega cada mañana sin acordarse de nada. Lo único que sabe es lo que haya encima de su escritorio. A ese escritorio se le llama ventana de contexto: el espacio donde caben tus mensajes, los documentos que adjuntas y las respuestas anteriores.
En el chat del navegador, ese escritorio se llena de tres formas: lo que escribes, lo que adjuntas y lo que la herramienta decida guardar en su memoria. De ahí salen tres límites.
1. La memoria. Si no repites el contexto, la IA no lo tiene. Tu cliente, tu tono, tus colores, las decisiones de la semana pasada: todo eso hay que volver a ponerlo, o confiar en que la memoria de la herramienta lo haya guardado bien.
2. La organización. Una conversación larga acaba siendo un cajón de sastre: ideas, borradores, datos y correcciones mezclados. Encontrar mañana "aquella versión buena" es una excavación.
3. Los archivos. Lo que la IA te da vive dentro de la conversación. Tú lo copias, lo pegas, lo guardas donde puedes. Y lo que subes tú, lo subes a mano, una y otra vez.
Justo es decirlo: el chat del navegador ya no es tan básico como era
Aquí conviene ser honestos, porque la historia no es "navegador malo, terminal bueno". El chat de Claude, por ejemplo, ya tiene tres cosas que antes no tenía:
- Proyectos: espacios donde subes documentos y escribes instrucciones, y Claude los usa en todos los chats de ese proyecto [2].
- Memoria y búsqueda en chats anteriores: está activada por defecto en los planes Free, Pro y Max, y cada proyecto tiene su propio espacio de memoria separado del resto [4].
- Más capacidad para tus documentos: cuando el conocimiento de un proyecto se acerca al límite de la ventana de contexto, Claude activa solo un modo de búsqueda (RAG) que, según su ayuda oficial, permite guardar hasta 10 veces más contenido [3].
Y aun así hay un detalle importante: el contexto no se comparte entre los chats de un proyecto, salvo que lo añadas al conocimiento del proyecto [2]. Es decir, lo que descubres en una conversación no pasa solo a la siguiente.
Si ya usas Proyectos y memoria, vas por delante de quien abre un chat en blanco cada vez. Lo que sigue explica el siguiente salto.
¿Qué cambia cuando la IA trabaja sobre una carpeta de tu ordenador?
Claude Code, Codex, Gemini CLI y Antigravity comparten una idea: en vez de que tú le pases los documentos, la IA trabaja dentro de una carpeta y lee los archivos que hay en ella. Eso resuelve los tres límites a la vez:
- Memoria: hay un archivo de instrucciones que la IA lee antes de empezar. Lo escribes una vez.
- Organización: los documentos son archivos reales, en carpetas que tú ordenas. Una carpeta por proyecto, y dentro de cada una, sus datos, sus entregas y sus resúmenes.
- Archivos: lo que la IA crea se guarda en la carpeta. Mañana sigue ahí, con su nombre y su fecha.
Cada herramienta lo llama de forma distinta, pero el principio es el mismo:
| Herramienta | Archivo de instrucciones | Cómo lo carga |
|---|---|---|
| Claude Code | CLAUDE.md (más una memoria automática que Claude escribe solo) | Al empezar cada sesión, lee el de tu carpeta y los de las carpetas superiores [1] |
| Codex (OpenAI) | AGENTS.md | Antes de empezar a trabajar, desde la raíz del proyecto hasta la carpeta donde estás; tope por defecto de 32 KiB [5] |
| Gemini CLI | GEMINI.md | Junta el global, el de tu espacio de trabajo y los de las carpetas que va visitando, y lo envía con cada prompt [6] |
| Antigravity | Reglas y flujos de trabajo, Knowledge y Artifacts | Su documentación oficial los presenta como componentes del agente; esa página no detalla cómo persisten [7] |
Dos detalles prácticos. Claude Code lee CLAUDE.md, no AGENTS.md; si ya tienes uno para otras herramientas, puedes crear un CLAUDE.md que lo importe con una línea (@AGENTS.md) y así todas leen lo mismo [1]. Y en Gemini CLI puedes ver exactamente qué está recibiendo el modelo con el comando /memory show [6]. Saber qué lee la IA es la mitad de arreglar sus fallos.
¿La IA "recuerda" de verdad con estas herramientas?
Aquí está la parte que casi nunca se cuenta. La documentación de Claude Code lo dice sin rodeos: cada sesión empieza con una ventana de contexto nueva. Lo que cruza de una sesión a otra son dos cosas: los archivos CLAUDE.md que escribes tú y la memoria automática, que son notas que Claude se escribe a sí mismo [1].
O sea: la IA no tiene un recuerdo mágico de ayer. Tiene archivos que lee hoy. Y eso tiene consecuencias útiles:
- Tú controlas lo que sabe. Son archivos de texto en formato Markdown. Los abres, los editas, los borras [1].
- Sobreviven a la limpieza. Si la conversación se hace muy larga y se compacta, el
CLAUDE.mddel proyecto se vuelve a leer desde el disco. Lo que solo dijiste de palabra en la conversación se puede perder [1]. - Las notas automáticas también son archivos. Claude Code guarda un índice (
MEMORY.md) y notas por tema; al empezar carga solo las primeras 200 líneas o 25 KB del índice, y el resto lo lee cuando lo necesita [1].
Y hay una advertencia que conviene tatuarse: la propia documentación aclara que Claude trata estas instrucciones como contexto, no como configuración obligatoria. Si algo no puede fallar nunca (por ejemplo, no tocar un archivo concreto), se programa como regla técnica, no como una frase en el archivo de notas [1].
Mi regla en la práctica: lo que quiero que la IA sepa siempre va a un archivo; lo que no puede ocurrir jamás se bloquea con configuración, no con una petición amable.
¿Más memoria es mejor memoria?
No. Y es la razón por la que "meter todo" en el archivo de instrucciones o en la conversación sale mal.
Dos estudios lo apoyan:
- "Lost in the Middle" (Liu y colaboradores, revista TACL, 2024): los modelos rinden mejor cuando la información relevante está al principio o al final del texto, y peor cuando queda en el medio, incluso los diseñados para textos largos [9].
- "Context Rot" (Chroma, julio de 2025): probó 18 modelos y vio que su fiabilidad cae a medida que crece el texto de entrada, también en tareas sencillas. En una prueba de memoria conversacional, los modelos puntuaron mucho más alto con un texto de unos 300 tokens centrado en lo importante que con unos 113.000 tokens de conversación completa [8].
Matices honestos: Chroma vende bases de datos para IA, así que tiene interés comercial en que se hable de cómo dar contexto a los modelos. Y los modelos que probó son de 2025; los actuales pueden comportarse mejor. Pero la conclusión coincide con las recomendaciones de los fabricantes: Claude Code aconseja que cada CLAUDE.md tenga menos de 200 líneas y avisa de que si dos reglas se contradicen, Claude puede elegir una al azar [1]. Codex corta por tamaño: por defecto deja de añadir archivos al llegar a 32 KiB [5].
La lección no es "ponle más memoria". Es "ponle la memoria correcta, corta y limpia".
Cómo se organiza un trabajo serio con IA
Esto es lo que te propongo y lo que usamos en DWC. No es la única forma, pero funciona con cualquiera de las cuatro herramientas:
mi-negocio/
├── reglas.md              ← lo que la IA lee siempre (corto)
├── proyecto-uno/
│   ├── start.md           ← qué es el proyecto y para quién
│   ├── estado.md          ← en qué punto estamos, en una página
│   ├── knowledge/         ← datos confirmados, con fecha y fuente
│   ├── output/            ← lo que la IA entrega, ordenado por fecha
│   └── sessions/          ← un resumen al cerrar cada sesión
└── proyecto-dos/
    └── ...
Y estas cinco costumbres hacen la mayor parte del trabajo:
- Un archivo de reglas corto. Tono, formato de entrega, lo que nunca debe hacer. Si crece, se parte.
- Una carpeta por proyecto. No mezcles clientes ni marcas. Cada proyecto solo lee lo suyo.
- Datos confirmados aparte. Cuando un dato queda validado (una cifra, un precio, una decisión), se anota con fecha y fuente. La IA trabaja con eso, no con lo que "cree recordar".
- Un resumen al cerrar la sesión. Cinco líneas: qué se decidió, qué quedó pendiente. Es lo primero que lee mañana.
- Nada de contraseñas ni datos personales en los archivos. Son texto plano y pueden acabar en una copia de seguridad, en un repositorio o en un equipo compartido. Esto es una norma de sentido común, no un requisito de las herramientas.
Un ejemplo del día a día: antes, cada vez que pedías un texto para una marca tenías que recordar el tono, los colores y lo que no se puede decir. Ahora ese contexto está escrito una vez. Pides "artículo para tal marca" y la IA arranca sabiendo cómo hablar, qué evitar y dónde guardar el resultado.
Los errores más comunes
- Un único chat eterno. Cuanto más largo, más texto irrelevante compite con lo importante [8][9]. Mejor sesiones cortas con resumen.
- Un archivo de reglas de 800 líneas. Se lee peor y se contradice más [1].
- Instrucciones solo de palabra. Si lo dijiste en la conversación y no lo escribiste en un archivo, puede perderse al compactar [1].
- Fiarte de la memoria sin mirarla. Revisa lo que la herramienta ha guardado. En Claude Code,
/memoryte lo enseña [1]; en Gemini CLI,/memory show[6]. - Delegar sin revisar. Que la IA lea tus carpetas no significa que acierte siempre. Lo importante lo compruebas tú.
Cómo empezar esta semana
- Elige un solo proyecto, el que más repites.
- Crea una carpeta para él y un archivo de reglas de máximo una página: quién es el cliente, cómo se habla, cómo quieres las entregas.
- Prueba una herramienta que lea carpetas. El nombre del archivo cambia (
CLAUDE.md,AGENTS.md,GEMINI.md), el principio no [1][5][6]. - Al final de cada sesión, pide un resumen de cinco líneas y guárdalo en
sessions/. - A las dos semanas, revisa el archivo de reglas: quita lo que sobra y arregla lo que se contradice.
Si usas Claude en el navegador y no quieres dar el salto todavía, empieza por los Proyectos: subes tus documentos clave y escribes las instrucciones una sola vez [2].
Preguntas frecuentes
¿Entonces el chat del navegador no sirve?
Sirve, y mucho, para preguntas sueltas, borradores rápidos y para explorar ideas. Lo que se queda corto es cuando la IA pasa a formar parte de tu trabajo diario y necesitas que recuerde, que ordene y que archive.
¿Necesito saber programar para escribir estos archivos?
No. CLAUDE.md, AGENTS.md y GEMINI.md son archivos de texto en formato Markdown, es decir, texto normal con algunos símbolos para los títulos y las listas [1][5][6].
¿La IA recuerda todo si trabajo con carpetas?
No. Cada sesión parte de una ventana de contexto nueva y solo carga los archivos de instrucciones y la memoria automática; el resto lo lee cuando lo necesita [1]. Por eso conviene que lo importante esté escrito, ordenado y corto.
¿Qué herramienta elijo: Claude, Codex, Gemini o Antigravity?
La que ya uses o la que mejor encaje con tu equipo. El principio es el mismo y el trabajo importante (reglas, datos confirmados, resúmenes) se hace en archivos que puedes reutilizar. Claude Code incluso permite importar un AGENTS.md para no duplicar nada [1].
¿Qué tamaño debe tener el archivo de reglas?
Claude Code recomienda menos de 200 líneas por archivo [1]. En Codex, el tope por defecto es de 32 KiB para el conjunto de archivos de instrucciones [5]. Mejor corto, concreto y verificable.
¿Quieres montar este sistema en tu negocio?
En Desarrollo Web Creativo trabajamos con IA y automatización aplicadas a negocios reales. Si quieres ordenar cómo usa la IA tu equipo (carpetas, reglas, flujos de entrega), cuéntanos tu caso y vemos por dónde empezar. Agendar llamada.
Fuentes
Consultadas el 8 de octubre de 2026. Las herramientas cambian rápido: verifica los detalles en la documentación oficial antes de configurar nada.
Documentación oficial:
- Anthropic. How Claude remembers your project (Claude Code). https://code.claude.com/docs/en/memory
- Anthropic. How can I create and manage projects? (Centro de ayuda de Claude). https://support.claude.com/en/articles/9519177-how-can-i-create-and-manage-projects
- Anthropic. Retrieval augmented generation (RAG) for projects (Centro de ayuda de Claude). https://support.claude.com/en/articles/11473015-retrieval-augmented-generation-rag-for-projects
- Anthropic. Use Claude's chat search and memory to build on previous conversations (Centro de ayuda de Claude). https://support.claude.com/en/articles/11817273-use-claude-s-chat-search-and-memory-to-build-on-previous-conversations
- OpenAI. Custom instructions with AGENTS.md (Codex). https://developers.openai.com/codex/guides/agents-md
- Google. Provide context with GEMINI.md files (Gemini CLI). https://geminicli.com/docs/cli/gemini-md
- Google. Agent (documentación de Antigravity). https://antigravity.google/docs/agent
Investigación:
- Chroma (14 de julio de 2025). Context Rot: How Increasing Input Tokens Impacts LLM Performance. Informe técnico de una empresa del sector, con interés comercial. https://www.trychroma.com/research/context-rot
- Liu, N. F., Lin, K., Hewitt, J., Paranjape, A., Bevilacqua, M., Petroni, F. y Liang, P. (2024). Lost in the Middle: How Language Models Use Long Contexts. Transactions of the Association for Computational Linguistics, vol. 12, pp. 157-173. https://aclanthology.org/2024.tacl-1.9/

Escrito por Sabino Figueroa
Arquitecto de soluciones y consultor técnico senior con más de 20 años de experiencia diseñando ecosistemas de software, aplicaciones web de alta velocidad y automatizaciones con IA en Alicante.
¿Necesitas asesoramiento técnico para tu empresa?
Podemos auditar tu código, optimizar la velocidad de tu web o implementar integraciones con Inteligencia Artificial.